10. Master en SQL Server- Desde Cero hasta Experto
¿Qué son las Bases de Datos?
Se llama base de datos o también banco de datos a un conjunto de información perteneciente a un mismo contexto.
Las bases de datos son el producto de la necesidad humana de almacenar la información, es decir, preservarla contra el tiempo y el deterioro para poder acudir a ella posteriormente.
Algunos ejemplos de las bases de datos a lo largo del tiempo son las guías telefónicas, archivos personales, bibliotecas, historial medico…
Las bases de datos son sistemas organizados para poder almacenar y gestionar grandes cantidades de información permitiendo la fácil recuperación, manipulación y actualización de los datos almacenados.
Las bases de datos pueden variar en complejidad y tamaño dependiendo de las necesidades específicas de cada aplicación o sistema.
Tipos de Bases de Datos
Hay muchos tipos de bases de datos, cada una diseñada para satisfacer las necesidades específicas y cada una con sus propias fortalezas y debilidades, la cual se clasifican en dos categorías bases de datos relacionales y bases de datos no relacionales.
Bases de datos relacionales
Las bases de datos relacionales son las más utilizadas, están diseñadas para almacenar datos estructurados en tablas relacionadas entre sí.
Las bases de datos relacionales son muy escalables y ofrecen una gran flexibilidad en cuanto a la forma en la que se pueden consultar los datos son ideales para aplicaciones que requieren transacciones en tiempo real, como sistema de gestión de inventarios, ventas o finanzas.
Utilizando el lenguaje SQL para poder realizar consultas y mandar instrucciones hacia las bases de datos.
Las bases de datos relacionales más populares y que se suelen usar en la mayoría de las empresas son Microsoft, SQL Server, MySQL, MariaDB, Oracle, PostgreSQL, DB2 de IBM y SQLite.
Ventajas
-
Estructura bien definida, cada tabla tiene un esquema específico que determina las columnas y los tipos de datos que puede contener.
-
Consistencia e integridad de los datos con la integridad referencial y las restricciones de esquema. Las bases de datos relacionales garantizan que los datos estén siempre en un estado coherente y fiable.
-
Capacidad de consulta avanzada, el lenguaje SQL proporciona una amplia gama de funciones y operaciones que permiten realizar consultas complejas como sumar, promediar, agrupar, filtrar datos, etcétera con gran precisión y eficiencia.
-
Transacciones, las bases de datos SQL permiten agrupar múltiples operaciones en una transacción, asegurando que todas se completen con éxito o que ninguna se aplique. Esto es crucial para operaciones que implican cambios en varias tablas a la vez.
Desventajas
-
Escalabilidad limitada en algunos casos, aunque las bases de datos relacionales pueden manejar grandes cantidades de datos, su escalabilidad horizontal suele ser más restrictiva que las bases de datos no SQL.
-
Cambio de esquema y flexibilidad, modificar el esquema de un sistema relacional puede ser un proceso laborioso.
-
Costo y licencia, algunas soluciones SQL, especialmente las empresariales, pueden ser costosas.
-
Rendimiento bajo cargas masivas. En situaciones donde se manejan varias cantidades de datos o grandes volúmenes de consultas simultáneas, las bases de datos SQL pueden enfrentar cuellos de botellas de rendimiento especialmente si no están optimizadas adecuadamente.
-
Complejidad en la gestión y mantenimiento. Dado que las bases de datos SQL tienen una larga historia y una amplia gama de funcionalidades, administrarlas y mantenerlas puede requerir un nivel de experiencia técnica elevado.
Bases de datos no relacionales
Las bases de datos no SQL o no relacionales no son estructuradas, es decir, no tienen una estructura bien definida.
Para poder ejecutar instrucciones en una base de datos no relacional se trabajan con APIs y cada base de datos no relacional tiene su propia documentación para poder trabajar y manipular los datos.
Cada base de datos no relacional trabaja bajo sus propias reglas dentro de las bases de datos no relacionales podemos encontrar distintos tipos como bases de datos clave, valor.
Algunos ejemplos de bases de datos no relaciones son:
- Redis y Amazon DynamoDB.
- Bases de datos orientadas a documentos, encontrándose las bases de datos como MongoDB, Couchbase y Elasticsearch.
- Base de datos orientada a grafos, teniendo a las bases de datos Neo Forja y Amazon Neptune.
- Bases de datos de columnas acá se encuentran las bases de datos de Apache Cassandra, Amazon Redshift y Apache HBase.
Ventajas
-
Escalabilidad horizontal, una de las principales ventajas de las bases de datos no relacionales es su capacidad para escalar horizontalmente. Esto significa que en lugar de aumentar la potencia del servidor, es decir, hacer un escalado vertical, puede simplemente agregar más servidores al sistema para poder manejar cargas de trabajo más grande.
-
Flexibilidad de esquema, dado que no están atadas a un esquema fijo, las bases de datos no SQL permiten una adaptabilidad en la estructura de los datos. Esto es útil para proyectos en desarrollo o aquellos que requieran ajustes y cambios constante.
-
Rendimiento optimizado para cargas específicas, las bases de datos no relacionales, como las bases de datos orientadas a documentos o las bases de datos de grafos, están optimizadas para tareas y consultas específicas, lo que puede resultar en un mejor rendimiento para ciertas operaciones.
-
Gestiones de Big Data, algunas de las bases de datos no relacionales están diseñadas específicamente para manejar Big Data, lo que las hace ideal para aplicaciones que requieran procesar y analizar vasta cantidad de información.
-
Adaptabilidad a las tendencias actuales, con el auge de las aplicaciones en tiempo real, también llamadas IoT y otras tecnologías empresariales, las bases de datos no relacionales ofrecen soluciones más adaptables a estos nuevos paradigmas.
Desventajas
-
Falta de estandarización, a diferencia de SQL, donde el lenguaje y las operaciones son bastante estándar. Existen muchas soluciones con diferentes formas de operación y consulta. Esta variedad puede complicar la elección y el proceso de aprendizaje.
-
Madurez relativa, aunque las bases de datos no relacionales han ganado mucha tracción y popularidad, muchas de ellas no tienen la misma historia y la madurez que las soluciones SQL establecidas. Esto puede reflejarse en la disponibilidad de herramientas, recursos de aprendizaje y soporte.
-
Consistencia versus disponibilidad, muchas bases de datos no relacionales siguen el teorema CAP, que postula que es imposible para un sistema distribuido garantizar simultáneamente la consistencia, disponibilidad y tolerancia a particiones.
-
Menor énfasis en la integridad de los datos, aunque la flexibilidad es una ventaja, también puede ser un desafío, especialmente cuando se trata de mantener la integridad de los datos en sistemas donde el esquema es variable o inexistente.
-
Curva de aprendizaje para aquellas personas que están acostumbradas al mundo relacional y al lenguaje SQL. El cambio a no SQL puede requerir un ajuste y un periodo de aprendizaje.
Definición de Tabla, Campo y Registro
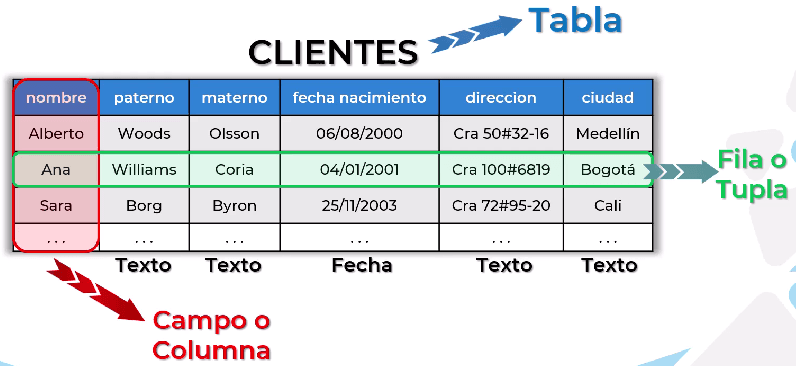
Una tabla es una estructura que contendrá un subconjunto de los datos en una base de datos. Es la estructura principal donde se guarda la información, ya que toda la información de una base de datos estará contenida en una tabla.
Un campo es una unidad individual de datos dentro de una tabla. También se conoce como columna.
Cada campo tiene un nombre único y no puede haber dos campos con el mismo nombre. A cada campo se define el tipo de dato que pueden contener como texto, números, fechas, etcétera. Los campos representan los diferentes atributos o características de los registros almacenados en la tabla.
Luego tenemos los registros que también se le conoce como fila o tupla.
Un registro es una instancia individual de los datos dentro de la tabla. Cada registro representa una entrada única de la base de datos y contiene valores específicos para cada campo definido en la tabla.
SQL (Structured Query Language)
SQL es un lenguaje de programación estándar para interactuar con las bases de datos relacionales.
SQL fue desarrollado en los laboratorios de investigación de IBM, específicamente en San José, California, fue desarrollado por Donald Chamberlin y Raymond Boyle.
El American National Standards Institute, también llamado ANSI y la International Organization for Standardization, también llamado ISO, reconocieron la importancia de estandarizar SQL y en 1996 se convirtió oficialmente en un estándar.
SQL tiene los siguientes tipos de instrucciones:
- El primero se llama DDL o lenguaje de definición de datos.
- El segundo se llama DML o lenguaje de manipulación de datos.
- El tercer grupo se llama DSL o lenguaje de control de datos
- El cuarto grupo se llama TCL o lenguaje de control de transacciones.
Estos cuatro grupos de instrucciones son los que forman SQL. Veamos algunas de las instrucciones de cada uno de estos grupos:
-
DDL o lenguaje de definición de datos Este lenguaje permite a los programadores de un sistema gestor de base de datos definir la estructura para almacenarán los datos para definir la estructura. Disponemos de tres sentencias:
- CREATE Se usa para crear una base de datos. También podemos crear una tabla, una vista, etcétera.
- ALTER se utiliza para modificar la estructura, por ejemplo, añadir o borrar columnas de una tabla.
- DROP con esta sentencia podemos eliminar los objetos de la estructura, por ejemplo un índice o una secuencia.
Estas son las instrucciones para definir la estructura que almacenarán los datos.
-
DML o lenguaje de manipulación de datos Permitiendo a los usuarios introducir datos para posteriormente realizar tareas de consultas o modificación de los datos que contienen las bases de datos.
Los ejemplos que se utilizan para manipular los datos son los siguientes:
- INSERT con esta instrucción podemos insertar valores en una base de datos.
- UPDATE sirve para modificar los valores de uno o varios registros.
- DELETE se utiliza para eliminar las filas de una tabla.
Dentro de este grupo de instrucciones también se encuentra la instrucción más utilizada en todas las bases de datos.
Estamos hablando de la instrucción de consulta SELECT, la cual se utiliza para realizar consultas sobre los datos.
-
DSL o lenguaje de control de datos Estos comandos permiten al administrador del sistema gestor de base de datos controlar el acceso a los objetos, es decir, podemos otorgar o denegar permisos a uno o más roles para realizar determinadas tareas.
Los comandos para poder controlar los permisos son los siguientes:
- GRANT que permite otorgar permisos
- REVOKE que permite eliminar los permisos que previamente se han concedido.
-
TCL o lenguaje de control de transacciones Cada transacción comienza con una tarea específica y finaliza cuando todas las tareas del grupo se completen con éxito.
Si alguna de las tareas falla, la transacción fallará. Por lo tanto, una transacción solo tiene dos resultados el éxito o el fracaso.
Los comandos para realizar la transacción son las siguientes:
- COMMIT que confirma una transacción.
- ROLLBACK deshace una transacción en caso de que se produzca algún error.
- SAVEPOINT que establece un punto de guardado dentro de una transacción.
- SET TRANSACTION inicializa una transacción en la base de datos.
Estas son las instrucciones que se utilizan para controlar las transacciones en una base de datos que se utiliza para confirmar o revertir una transacción.
También se tiene comandos para el control de flujos, los condicionales como if, else y while.
También existen comandos propios de cada sistema gestor de base de datos relacionales, es decir, cada competidor adecúa sus instrucciones para poder cumplir con los estándares y también implementar nuevas funciones para poder diferenciarse de otros competidores.
¿Qué es Microsoft SQL Server?
Microsoft SQL Server es un sistema de administración de base de datos relacionales (RDBMS).
Las aplicaciones y las herramientas se conectan a una instancia o base de datos SQL Server y se comunican mediante Transact SQL, también llamado T-SQL.
Basado en el lenguaje Transact, SQL incorpora un conjunto de extensiones de programación propias del lenguaje estándar y su aplicación está disponible para usarse tanto al nivel on premise o bajo una modalidad cloud.
El motor de base de datos Microsoft SQL Server cuenta con cuatro ediciones diferentes destinadas para cada diferentes perfiles de usos.
-
Enterprise - Siendo la edición más completa, está destinada para aquellas organizaciones que requieren trabajar con alto nivel de servicio de cargas de trabajos críticos.
-
Estándar - Destinada para ofrecer a las pequeñas empresas una herramienta que les brinde una administración básica de los datos para la ejecución de sus aplicaciones.
-
Express
- Admitiendo herramientas de desarrollo comunes a nivel on premise o entornos Cloud Express.
- Diseñada para aquellas personas principiantes que deseen disponer de una base de datos gratuita como aprendizaje.
-
Developer
- Integra toda la funcionalidad de la versión Enterprise, para entornos de prueba y no debe utilizarse en entorno de producción.
- Esta versión está diseñada para todos aquellos desarrolladores que deseen disponer de un sistema de prueba y desarrollo para la complicación de cualquier tipo de aplicación en SQL Server.
El motor de base de datos SQL Server también lo usan los siguientes productos y servicios como
- Azure SQL Database
- Instancia administrada de Azure SQL
- Microsoft Analytics Platform Systems
- Azure Synapse Analytics
- Azure SQL Edge
Algunos componentes y tecnologías en SQL Server son:
- SQL Server Integration Services (SSIS)
- SQL Server Analysis Services (SSAS)
- SQL Server Reporting Services (SSRS)
- Data Quality Services (DQS)
- Master Data Services (MDS)
¿Qué es SQL Server Management Studio?
Es una interfaz gráfica de usuario que proporciona un entorno integrado para poder administrar cualquier infraestructura relacionada con SQL Server.
Con SQL Server Management Studio, los usuarios pueden configurar, gestionar y administrar bases de datos relacionales, así como instancias de Azure SQL Database y Azure SQL.
Atajos de teclado más utilizados
Lista con los atajos de teclados más utilizados en SQL Server Management Studio(SSMS):
- General:
- Ctrl + N: Abrir una Nueva Consulta.
- Ctrl + O: Abrir un Archivo del Ordenador.
- Ctrl + S: Guardar el Archivo de Script Actual.
- F5: Ejecutar el Script Seleccionado o Todo el Script.
- F8: Mostrar panel Object Explorer.
- Ctrl + Alt + L: Mostrar panel Solution Explorer.
- Ctrl + R: Mostrar u ocultar el panel de resultados.
- Ctrl + Shift + U: Cambiar el texto seleccionado a mayúsculas.
- Ctrl + Shift + L: Cambiar el texto seleccionado a minúsculas.
- Ctrl + K + C: Comentar la selección.
- Ctrl + K + U: Descomentar la selección.
- Navegación y edición:
- Ctrl + G: Ir a un número de línea específico dentro del script.
- Ctrl + Shift + Flecha izquierda/derecha: Seleccionar palabras completas a la izquierda/derecha del cursor.
- Shift + Flecha arriba/abajo: Seleccionar bloques de texto hacia arriba/abajo.
- Resultados y cuadrícula:
- Ctrl + D: Modo de visualización de cuadrícula.
- Ctrl + T: Modo de visualización de texto.
- Ctrl + Shift + F: Guardar el resultado del script seleccionado en un archivo.
Introducción a los Tipos de Datos
Los tipos de datos son utilizados para definir el tipo de información que puede almacenarse en una columna de una Tabla.
Cada columna en un Tabla debe de tener un tipo de datos específico que determine el formato y el rango de valores que puede contener.
